边缘端接设备,常见结局是每来一种新设备就多一套专用流程,越接越难维护。本文拆解统一采集契约、自定义API脚本与版本化调用地址三个设计点,说明如何把工艺逻辑从驱动里解耦。适合正在做MES设备接入与二次开发的制造企业参考。
软件最理想的运行环境是演示机。真实产线上跑的是网络波动、脏数据、临时改的需求,和屏幕前那台机器完全不是一回事。设备接入尤其如此——实验室里调通一个协议只要半天,到了车间,COM口、文件流、扫码枪、检测报告各走各的路,每接一种新设备就多一套专用流程。系统还没上线,维护清单已经比设备清单长了。
一、为什么设备越接越多,代码越写越乱?
很多工厂的边缘端采集是这样长出来的:第一台设备走串口,写一套解析;第二台设备走文件,再写一套;第三台设备工艺不一样,又得改驱动。设备越多,驱动越厚,最后没人敢动。
问题的根子不在设备,在于把“工艺逻辑”和“通信逻辑”焊死在了一起。通信本该只负责把数据搬进来,工艺判断、数据组合、缓存等待这些事,应该交给按设备工艺写的脚本去处理。这两层不拆开,接一台设备就得改一次底层。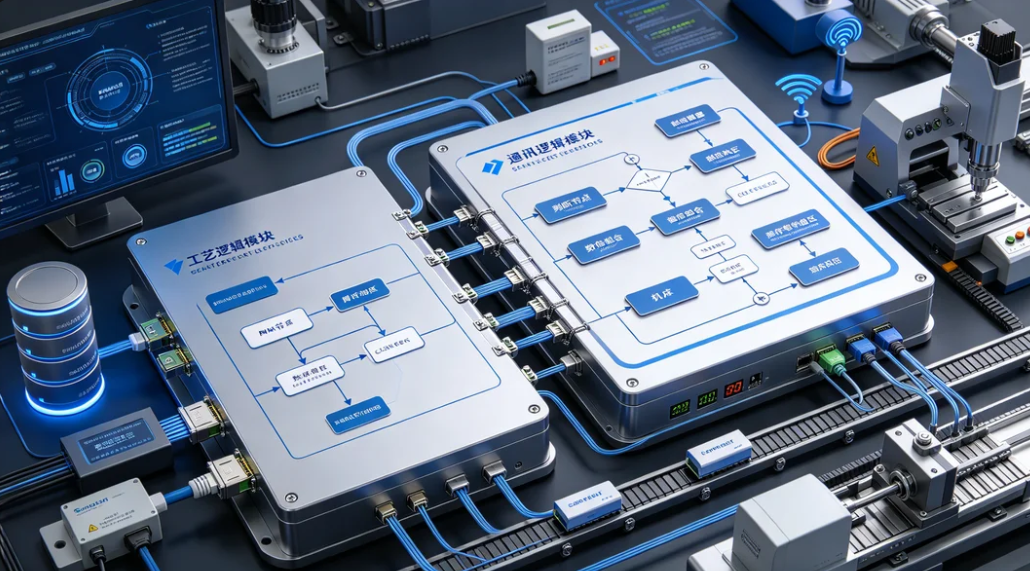
二、统一入口:一次通信,一次独立请求
拆法的第一步是统一采集契约。每次通信服务收到一条数据,就形成一次独立请求,请求里携带通信类型、原始数据、设备与驱动信息、协议参数明细。COM串口和文件流走同一个入口转交平台,平台再按设备编号解析站点、已发布的采集方案和绑定的自定义API。
这里有个关键设计:调用地址按最新已发布版本动态生成(/custom/v{版本}/{编号}),版本号不写死。后续API升级,不用回头改采集端代码。对工厂来说,这意味着换工艺、升脚本,不必停线改底层。
三、可组合采集:先扫码后检测,怎么串?
同一台设备可以配置COM加一个或多个文件源,按工艺顺序多次调用同一个自定义API。“先扫码后检测”“多份检测报告组合提交”这类场景,关联、缓存、等待、提交的逻辑全部由API脚本实现,采集端不参与判断。
需要说清楚边界:COM和FILE是目前已实现并写了对接文档的来源;TCP、RabbitMQ预留了扩展位置但尚未测试通过,不当作已验证能力;PLC、数据库、通用HTTP不在本次验收范围。把已验证和未验证分开标注,现场验收才不会被“看起来都能接”误导。
四、版本绑定与状态日志:出问题怎么查?
采集方案在平台侧维护并配置自定义API编号,发布版本后与设备绑定。平台只取设备实际绑定的最新已发布方案,未配置API或没有已发布版本时返回明确错误,而不是静默失败——静默失败在现场是最贵的故障,数据没上来,没人知道。
自定义API返回Status、Message、Data,边缘端按1成功绿色、2失败红色、3警告橙色输出日志,现场人员一眼能辨状态。平台对每次出站调用写入日志库,保留设备驱动、API地址、请求头体、原始响应、状态码,可按日志ID原样重放历史调用。排查问题时能复现现场那一次请求,比翻代码猜快得多。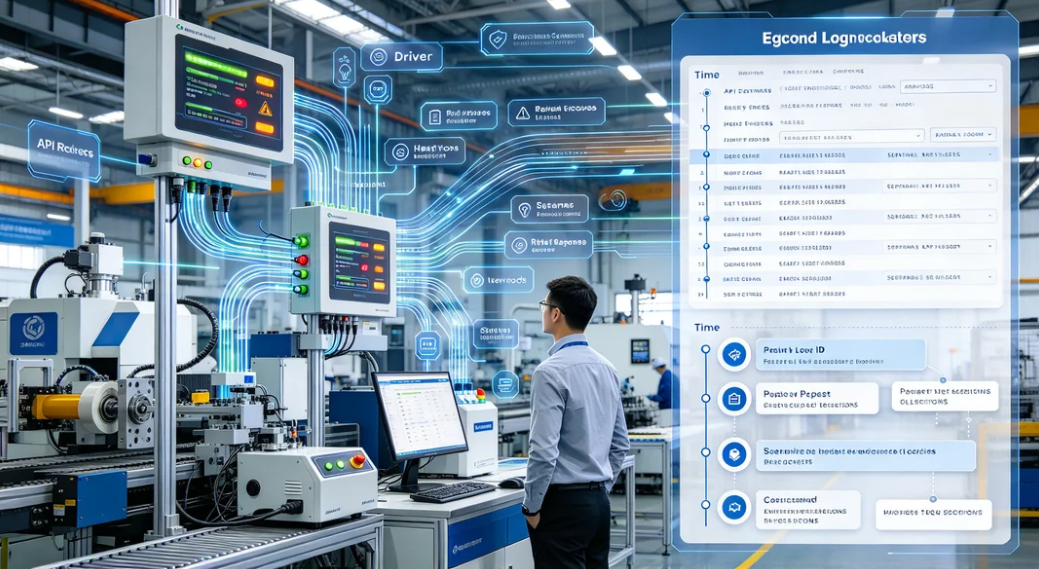
兼容性上,历史设备类型与旧采集入口行为保持不变,新协议事件走独立链路,存量设备不受影响。这是工业软件做迭代的底线:新能力可以慢一点上线,但不能让老设备先停摆。
精工智能数字化工厂的研发,把现场当考场——在真实数据、真实网络、真实操作习惯里把系统磨稳,而不是在办公室把功能做完就算交付。设备接入这件事,接得快不快是一时的,接得稳不稳、以后加设备还改不改底层,才是工厂三年后还在算的账。