这两年 AI 进厂,最常见的结局是停在演示阶段。屏幕上的智能很聪明,产线上的智能还在排队。
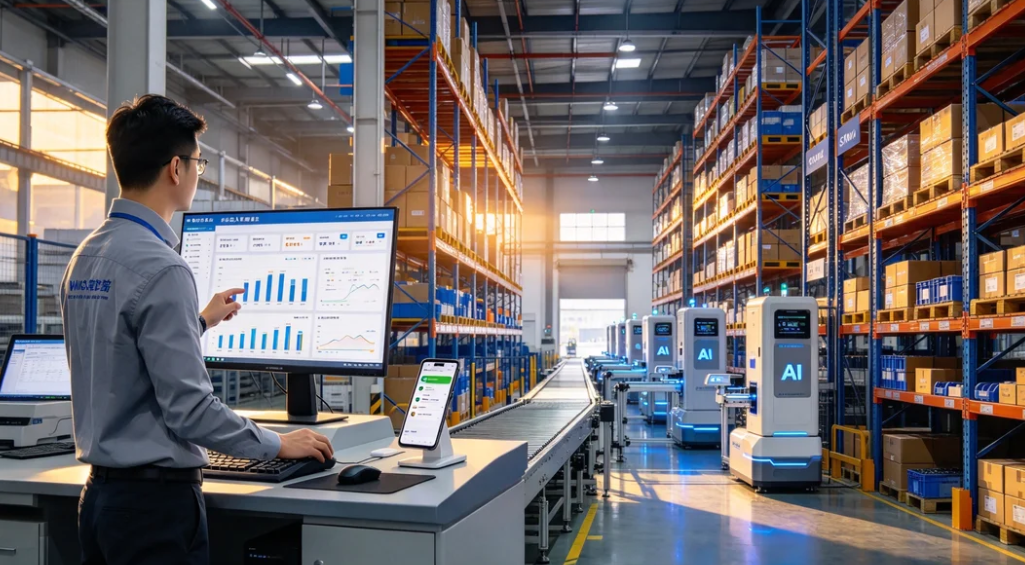
SKU 上万的仓库最典型。早上八点,仓管主管先打开 WMS 看昨日入库,然后打开微信问三句话:A 类物料周转是不是又慢了、C 线明天会不会缺料、昨天拣货为什么拖到下午才清完。数据在系统里,答案在人嘴里。WMS 用了几年,账是记全了,可它不会回答问题——这是不少多品种、小批量工厂当下的真实状态。
一、数据都在系统里,为什么答案还在人嘴里?
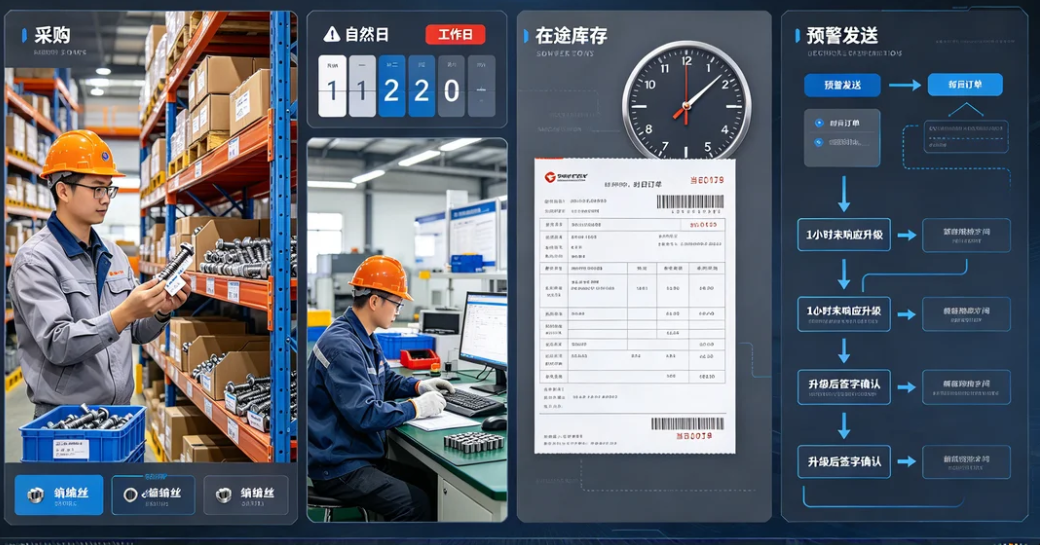
因为"录得进去"和"答得出来"是两件事。单据流不等于业务流:入库单、出库单、调拨单都在,但一张单背后的物料、批次、工单、责任人是散的。字段都有,口径没有——同一个"库存周转",计划算的是自然日、仓库算的是工作日、财务还要扣在途,三个数在三个 Excel 里。
口径不统一时,AI 助手答得越快越危险。它给出的数只要和车间主任手里的账对不上一次,这个功能就再也没人打开。这也是很多 AI 问答停在演示阶段的真实原因:不是模型不行,是底下的账撑不住一句追问。
二、要让系统答得上来,先统一哪三样东西?
物料口径。一物多码是 SKU 多的仓库第一道坎。同一个螺丝在采购、仓库、车间有三个编码,问"这颗料还够几天"就永远问不出答案。
时间口径。周转按自然日还是工作日、在途算不算库存、当天的单算不算当日,这三条不写进系统规则,问出来的数只能当参考,不能当决策依据。
责任口径。缺料预警最怕"都发了但没人管"。预警发给谁、几小时没响应升级到谁、升级后谁签字,这是流程问题,不是算法问题。
这三样统一,问题才能从"打电话问"变成"系统里查";不统一,再强的 AI 也只是把错误答案说得更流利。精工智能数字化工厂在做仓储项目时,把这三件事放在上线前的数据治理里做,而不是等系统跑起来再补——口径是地基,AI 是后面盖的楼。
三、库存周转、缺料预警、拣货效率,三类问题各该答到什么程度?
答案的标准不是"有个数",是"能直接拿去做决定"。
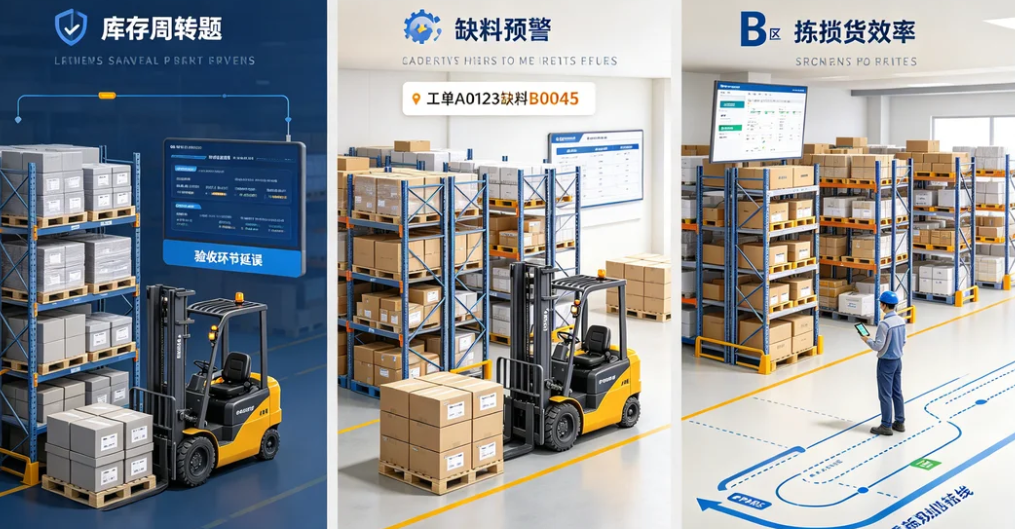
库存周转:要答口径、时间窗和对比基准。合格答案是"这个物料周转比上月慢了 0.8 天,卡在验收环节",而不是丢一个 12.3 天的数字。
缺料预警:要答提前量和齐套。合格答案是"哪张工单、缺哪颗料、最晚什么时候必须到货",而不是一句"存在缺料风险"。
拣货效率:要答到人时、单量和动线。合格答案是"昨天下午 B 区慢,是储位调整后动线变长",而不是"效率下降 15%"。
三类问题有一个共同点:答案必须能追到具体单据和具体环节。追不到,就只是统计报表,不是能开口答问题的系统。
四、先让哪个岗位用上"会答的系统"?
不建议一上来就做聊天框。先挑两个"答得上、敢签字"的场景:计划问缺料,仓库主管问周转。这两个问题每天都在发生,答案错了当天就会被发现,反馈闭环最短。
反过来也要说清楚:什么时候不该先上 AI 问答。主数据还在一物多码、单据还靠事后补录、异常没有责任人的仓库,先把 WMS 用扎实,比先接一个大模型更省时间。数据沉淀到位,AI 助手才有东西可答;沉淀不到位,接上去只是把混乱加速。
精工智能数字化工厂的 AI 赋能,做的不是让 AI 出现在大屏上,而是让数字员工真正站到岗位上——巡检、报工、辅助判断,该干活的地方有它干活。
仓库这一环,数字员工的第一份工作不是聊天,是回答三个具体问题:这颗料还能撑几天、这张工单会不会停线、昨天为什么慢。答案能从系统里直接调出来,AI 才算真正进了仓库;调不出来,就该回去补数据,而不是回去换模型。